
Argon 要開 high、換工具,還是先看自己的任務?
先留在同一個工具,比較任務成果與完整用量。這次high、medium各三次的結果重疊;Gemini CLI對照只有一次。值得採用的是逐次紀錄的讀法,尚不能照名次決定effort或照彙總保證省錢。
整理範圍 一位測試者、兩個固定專案。Antigravity三個effort各三次,加一個Gemini CLI high單次對照;low的judge記錄另有衝突。整合作者原帖、公開JSON與逐repo紀錄;本站未重跑。
依使用情境決定
正在選medium或high的人
先用同工具、相同任務重複驗收,別只追平均多出的1.4個。
high 37–45,medium 33–46;最高單次反而在medium,不能用單次46認定medium穩定較好。
案例:相同工具:high與medium各三次,範圍重疊 · 來源:原始 runs.csv:逐次分數、時間與high費用缺口 · 來源:Bug Hunt:方法、逐列註記與更正彙總
想因為便宜而換CLI的人
一起記錄token、cache、重試與中斷;暫不把這張表換成保證省費倍率。
Gemini CLI只有n=1;high更正彙總與逐次紀錄不一致,帳單也沒有公開。
案例:Gemini CLI單次,與未能逐次對帳的Antigravity彙總 · 來源:原始 runs.csv:逐次分數、時間與high費用缺口 · 來源:repo1-metrics.csv:工具版本、用量與續跑註記 · 來源:repo2-metrics.csv:工具版本、用量與中斷註記 · 來源:Bug Hunt:方法、逐列註記與更正彙總
想把low當省錢預設的人
把low結果當補充,等相同judge與完整端到端計時。
JSON稱low改用Grok,但逐repo紀錄仍混有Codex標記;兩次repo2還經中斷續跑,並非只調一個參數。
案例:low三次完成,但judge紀錄互相矛盾 · 來源:Bug Hunt:方法、逐列註記與更正彙總 · 來源:repo2-metrics.csv:工具版本、用量與中斷註記
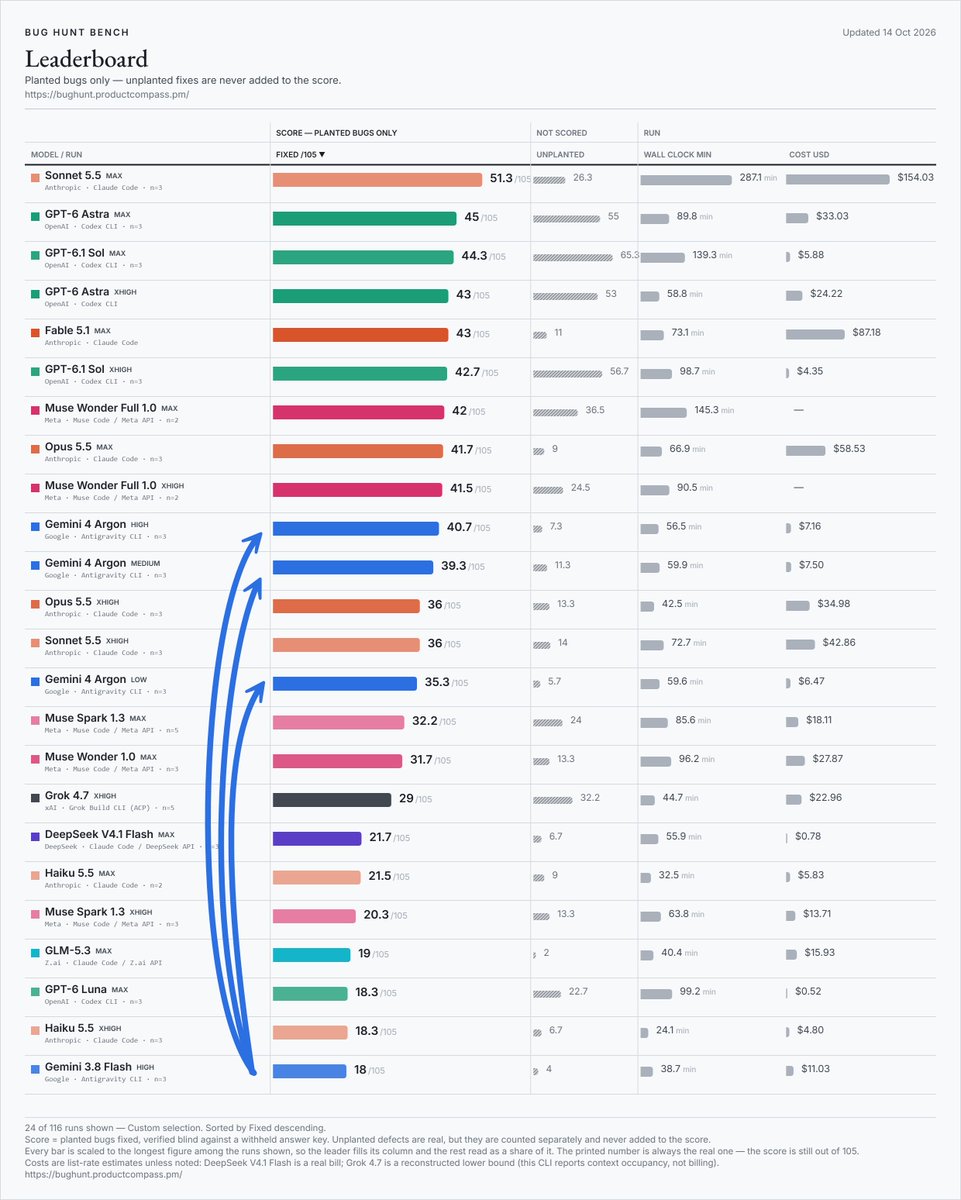
來源圖片
從案例看出什麼
第三次結果,改變了「high比較划算」的直覺
medium前兩次33、39,第三次46,平均由36升到39.3;high三次40、45、37,平均40.7。作者對46感到意外,但更多思考是否可靠地多修好問題,仍需更多重跑。小平均差不等於固定優勢。
案例:相同工具:high與medium各三次,範圍重疊 · 來源:同作者:medium第三次46分與個人反應 · 來源:原始 runs.csv:逐次分數、時間與high費用缺口
費用更正後,逐次紀錄仍未補齊
目前JSON/原帖列high平均US$7.16,並說早期CLI計數偏低;但runs.csv三次費用留白,明寫逐次紀錄無法對上更正彙總。逐repo CSV留下的舊估算相加,仍接近較早的US$5.82平均。因此保留7.16為來源更正值,不把它當已逐次核對的實付費用。
案例:Gemini CLI單次,與未能逐次對帳的Antigravity彙總 · 來源:Bug Hunt:方法、逐列註記與更正彙總 · 來源:原始 runs.csv:逐次分數、時間與high費用缺口 · 來源:repo1-metrics.csv:工具版本、用量與續跑註記 · 來源:repo2-metrics.csv:工具版本、用量與中斷註記
完成時間,沒有包含所有中斷的空白
high第二次曾因預付額度耗盡停止,補值後接同一對話;medium第三次repo1也因本機gateway遭中斷而續跑。來源加總工作片段,移除空白;多次執行共用電腦。表中的分鐘數適合描述這些紀錄,無法承諾使用者從下指令到收工要等多久。
案例:相同工具:high與medium各三次,範圍重疊 · 案例:Gemini CLI單次,與未能逐次對帳的Antigravity彙總 · 案例:low三次完成,但judge紀錄互相矛盾 · 來源:Bug Hunt:方法、逐列註記與更正彙總 · 來源:repo1-metrics.csv:工具版本、用量與續跑註記 · 來源:repo2-metrics.csv:工具版本、用量與中斷註記
low的裁判紀錄有衝突,先別畫成純參數曲線
low三次36、32、38,平均35.3。JSON稱因Codex帳號無法再用gpt-5.5而全改Grok 4.7;逐repo CSV卻仍標Codex,部分另記Grok,本站無法確認每次最終judge。medium/low少量CLI側呼叫仍是HIGH;不能把分數差全歸因於effort。
相同Antigravity,三次找漏的平均
| 指標 | Argon medium | Argon high |
|---|---|---|
| 平均修復植入錯誤(個 / 105) | 39.3 | 40.7 |
逐次medium 33/39/46,high 40/45/37。平均相差1.4個,小於各組已觀察到的13與8個波動範圍;不是信賴區間,也不足以建立穩定勝負。medium部分CLI側呼叫仍用HIGH;續跑與共用電腦條件見個案。
個案紀錄:任務、結果與限制
相同工具:high與medium各三次,範圍重疊
Paweł Huryn / Bug Hunt Bench · 發布 · 查閱 10/16 16:35(台北)
- 任務
- 在兩個專案找出並修復植入的105個錯誤;不提供錯誤清單。
- 設定
- Antigravity CLI 1.3.5,企業gateway模式接Gemini API key,服務模型gemini-4-argon;high/medium各三次,Codex gpt-5.5盲評。medium少量CLI側呼叫仍HIGH。
- 結果
- high 40/45/37,平均40.7;medium 33/39/46,平均39.3。來源分鐘數平均56.5與59.9;medium三次估算US$6.81/6.69/9.01,非帳單。
- 限制
- 每組只有三次;medium第三次repo1中斷後續跑,時間為工作片段總和,多次共用電腦。沒有建立穩定排名或時間優勢。
- 與產品的關係
- The Product Compass電子報作者與測試維護者,導流自己的內容;廠商合作條件未查核。
- 證據類型
- 作者自做第三方測量;已讀完整medium原帖、同作者最終更新及公開CSV,本站未重跑。
最後那次讓我非常意外。Paweł Huryn / Bug Hunt Bench 的原話忠實翻譯 · 短節錄
對照原文
The last one was a big surprise.原始個案:開啟原始貼文/頁面 ↗ · 來源清單:同作者:medium第三次46分與個人反應
Gemini CLI單次,與未能逐次對帳的Antigravity彙總
Paweł Huryn / Bug Hunt Bench · 發布 · 查閱 10/16 16:35(台北)
- 任務
- 同一模型high,換CLI執行同一套找漏任務。
- 設定
- Gemini CLI 0.63.0+本機gateway固定high,Google API;Antigravity CLI 1.3.5 gateway模式自帶HIGH。前者一次,後者三次;不同日期、請求與cache行為。
- 結果
- Gemini CLI 33/105、85.1分鐘,牌價估算US$32.08;Antigravity平均40.7/105,來源更正彙總US$7.16。作者自報cache命中約69%與89%,不是訂閱池消耗。
- 限制
- high逐次CSV費用留白,公開逐repo舊估算無法對上7.16;不刊逐次新拆帳或省費倍率。Antigravity第二次因預付額度中斷續跑,Gemini CLI遇spend-rate限制延後。長提示是否另加價,來源仍保留疑問。
- 與產品的關係
- 同一測試者與同一套題目,不是另一份獨立測試;非Google官方成績。
- 證據類型
- 已讀逐次與兩repo原始紀錄;彙總及費用衝突明列,未取得提供者原始計費明細/帳單。
原始個案:開啟原始貼文/頁面 ↗ · 來源清單:原始 runs.csv:逐次分數、時間與high費用缺口
low三次完成,但judge紀錄互相矛盾
Paweł Huryn / Bug Hunt Bench · 發布 · 查閱 10/16 16:35(台北)
- 任務
- 同一套找漏任務,主模型呼叫設low。
- 設定
- Antigravity CLI/API gateway;JSON稱三次改Grok 4.7,逐repo CSV卻保留Codex gpt-5.5標記,部分另記Grok。來源說因Codex帳號拒絕而換judge,本站未能確認每次最終評分者。
- 結果
- 36/32/38,平均35.3/105;來源估算US$6.24/5.97/7.19,平均US$6.47,非實付帳單。
- 限制
- 兩次repo2中斷續跑,包含gateway等待回應、手動中斷及預付額度耗盡;只計工作片段。judge紀錄衝突、少量側呼叫HIGH,不能把分數差全部歸因於low。
- 與產品的關係
- 同一測試者的延伸試跑;沒有增加獨立作者。
- 證據類型
- 已讀公開JSON說明與逐次表;judge衝突保留,本站未重跑或重新評分。
原始個案:開啟原始貼文/頁面 ↗ · 來源清單:Bug Hunt:方法、逐列註記與更正彙總
官方與評測背景
- Bug Hunt 是兩個既有專案:28K行TypeScript VS Code擴充、60K行React/Supabase LMS,共105個植入錯誤。測試保持綠燈,各模型收到相同提示、每repo一輪;依diff盲評,只計入植入錯誤,其他修正不加分。[3]
- 本文使用10/16查閱版本,資料標示更新日10/14;作者最後結果帖為台北10/15 04:51。這是同一位測試者的多次執行,沒有本站重跑,也不是多位使用者的共識。[1]
- 官方API列low/medium/high,medium為預設;每百萬輸入US$2、快取命中輸入US$0.10、輸出含thinking US$10的介紹期到11/30。以下cost_kind=list均為來源的牌價估算,非帳單、訂閱額度或任務報價。[7]
尚未解決的限制與後續觀察
- 固定兩個專案、各effort三次,未測中文閱讀、視覺品質或每個真實專案;未植入修復不計分。
- 來源為單一測試者,公開紀錄可供檢查,但不是本站驗證過的完整原始呼叫與實付帳單。
- 分數由模型judge判定,不是人類全面驗收;low的judge記錄矛盾與續跑條件尚待釐清。
- 原帖結果圖保留作者當時選出的模型;其他模型條件與費用種類不同,不能由圖推論普遍排名。
- 等更多同設定重跑、相同judge的low比較,以及完整保留中斷與等待的端到端時間。
- high更正彙總US$7.16,與公開逐repo紀錄尚未對上;等待可逐次重算的提供者用量與計價依據。
- 這套題目的未植入修復不計分;沒有衡量日常專案全部效益,也不能推出中文互動或3D作品的品質。
來源與查核
- Paweł Huryn:三個effort最終結果與原圖 ↗測試作者原帖/同作者後續 · 原文日期 2026.10.15 · 查核 10/15 18:37(台北)
- 同作者:medium第三次46分與個人反應 ↗原始體驗回報/非獨立樣本 · 原文日期 2026.10.14 · 查核 10/16 16:35(台北)
- Bug Hunt:方法、逐列註記與更正彙總 ↗第三方公開測量資料/本站未重跑 · 查核 10/16 16:35(台北)
- 原始 runs.csv:逐次分數、時間與high費用缺口 ↗原始執行紀錄/非帳單 · 查核 10/16 16:35(台北)
- repo1-metrics.csv:工具版本、用量與續跑註記 ↗測試者逐repo紀錄 · 查核 10/16 16:35(台北)
- repo2-metrics.csv:工具版本、用量與中斷註記 ↗測試者逐repo紀錄 · 查核 10/16 16:35(台北)
- Google API:effort、快取與含thinking單價 ↗官方API文件 · 查核 10/15 18:37(台北)
本文整理已公開的個案,不代表普遍使用情況。引言保留作者歸屬與原文連結,數據與限制以各自來源為準。