Argon 調高 effort 值得嗎?三次找漏測試與對不上的費用
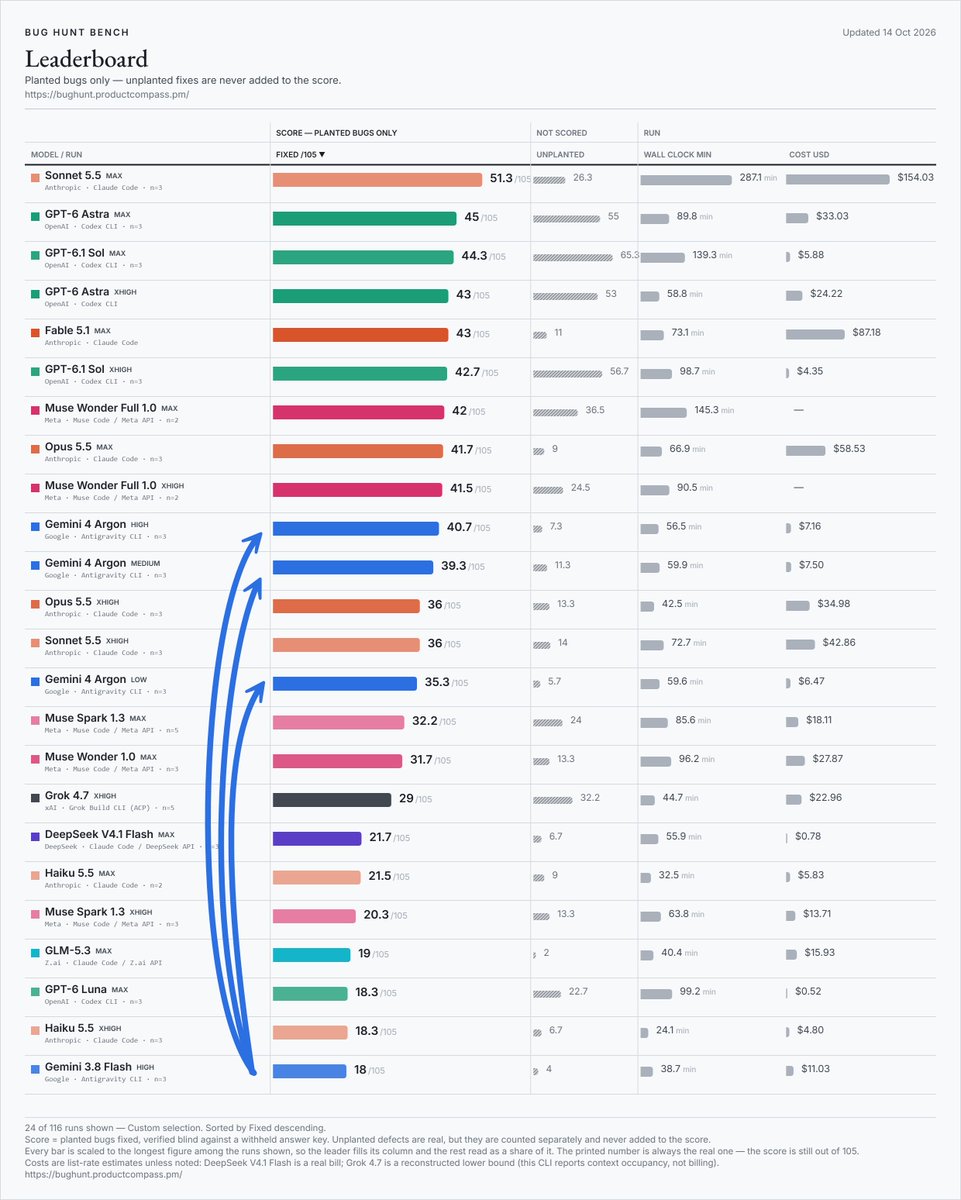
同一套105個錯誤,Antigravity 的 high 三次修復37–45個,medium 是33–46個;平均差距還不足以選出穩定贏家。Gemini CLI 單次牌價估算較高,但新版彙總與逐次紀錄對不上。讀原帖、公開紀錄與中斷條件,比看名次有用。
依本站整理發布日期回看內容;每篇另外標示原始事件日期。
同一套105個錯誤,Antigravity 的 high 三次修復37–45個,medium 是33–46個;平均差距還不足以選出穩定贏家。Gemini CLI 單次牌價估算較高,但新版彙總與逐次紀錄對不上。讀原帖、公開紀錄與中斷條件,比看名次有用。
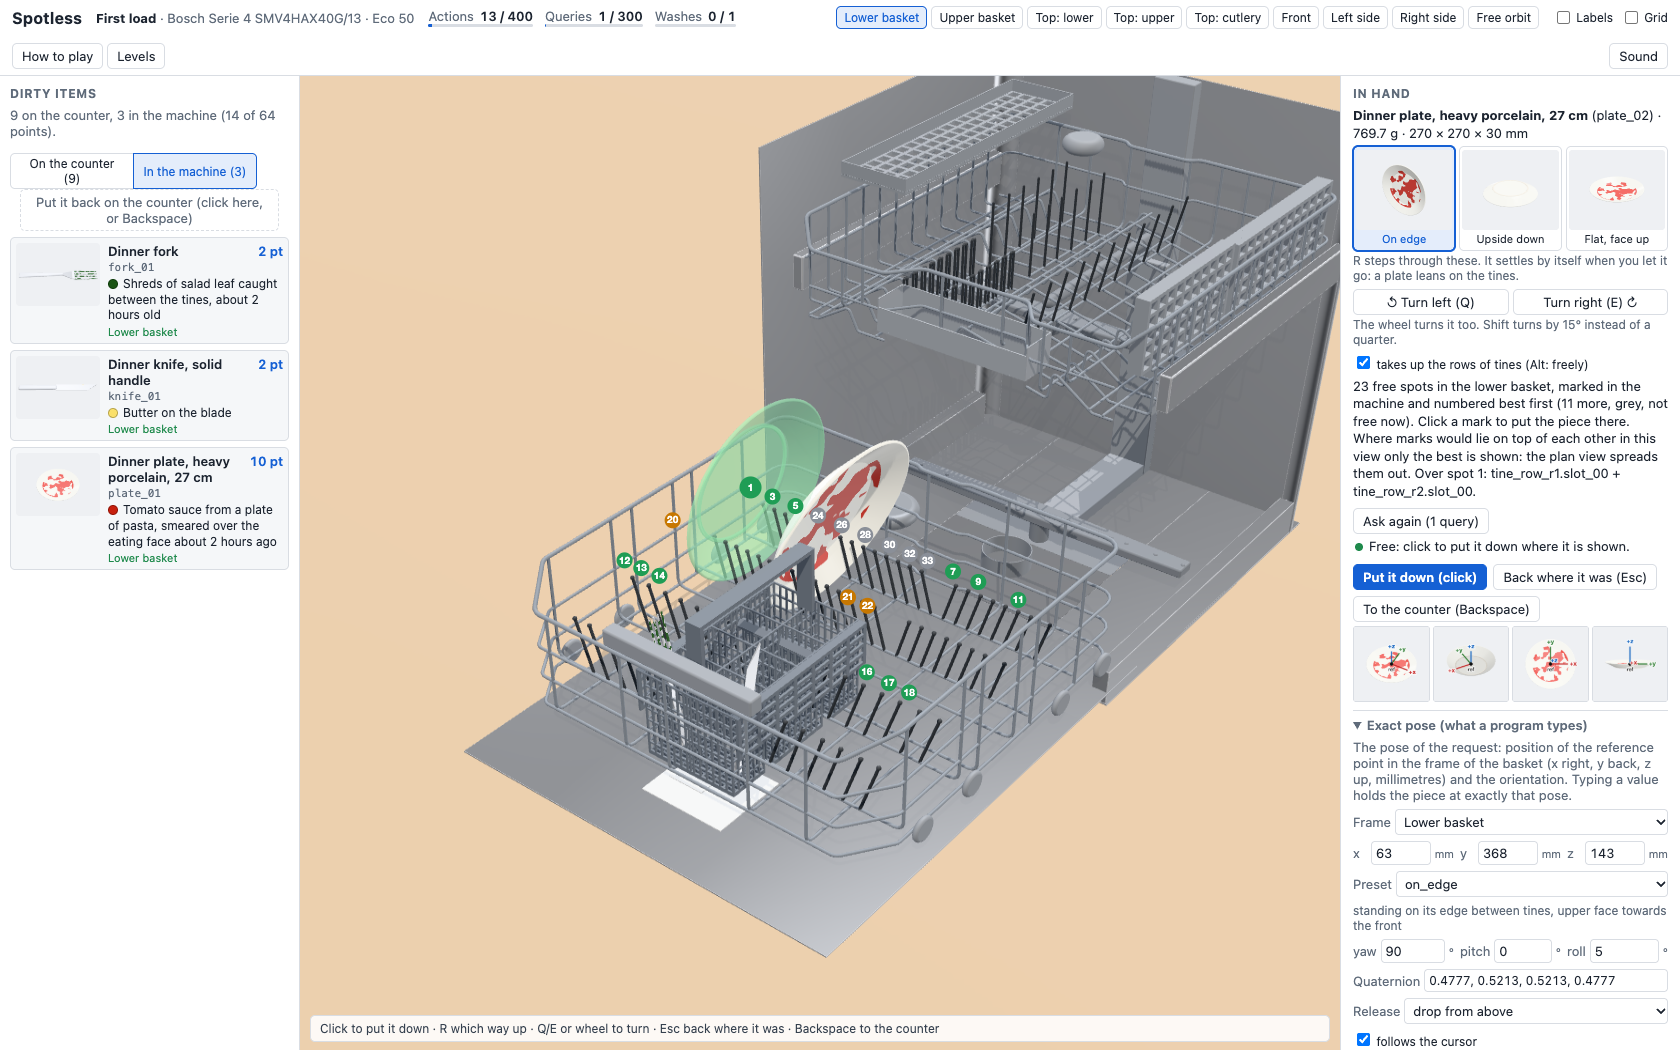
DishwasherBench 公開六次模型遊玩與逐步紀錄:Sol 會把擋住餐具籃的鍋子拿掉,Astra 會找空間多放大件餐具。但早期模擬器對倒下的盤子、擁擠餐具有盲點;這場遊戲目前更像裝載測試,不能直接當成洗碗能力排名。
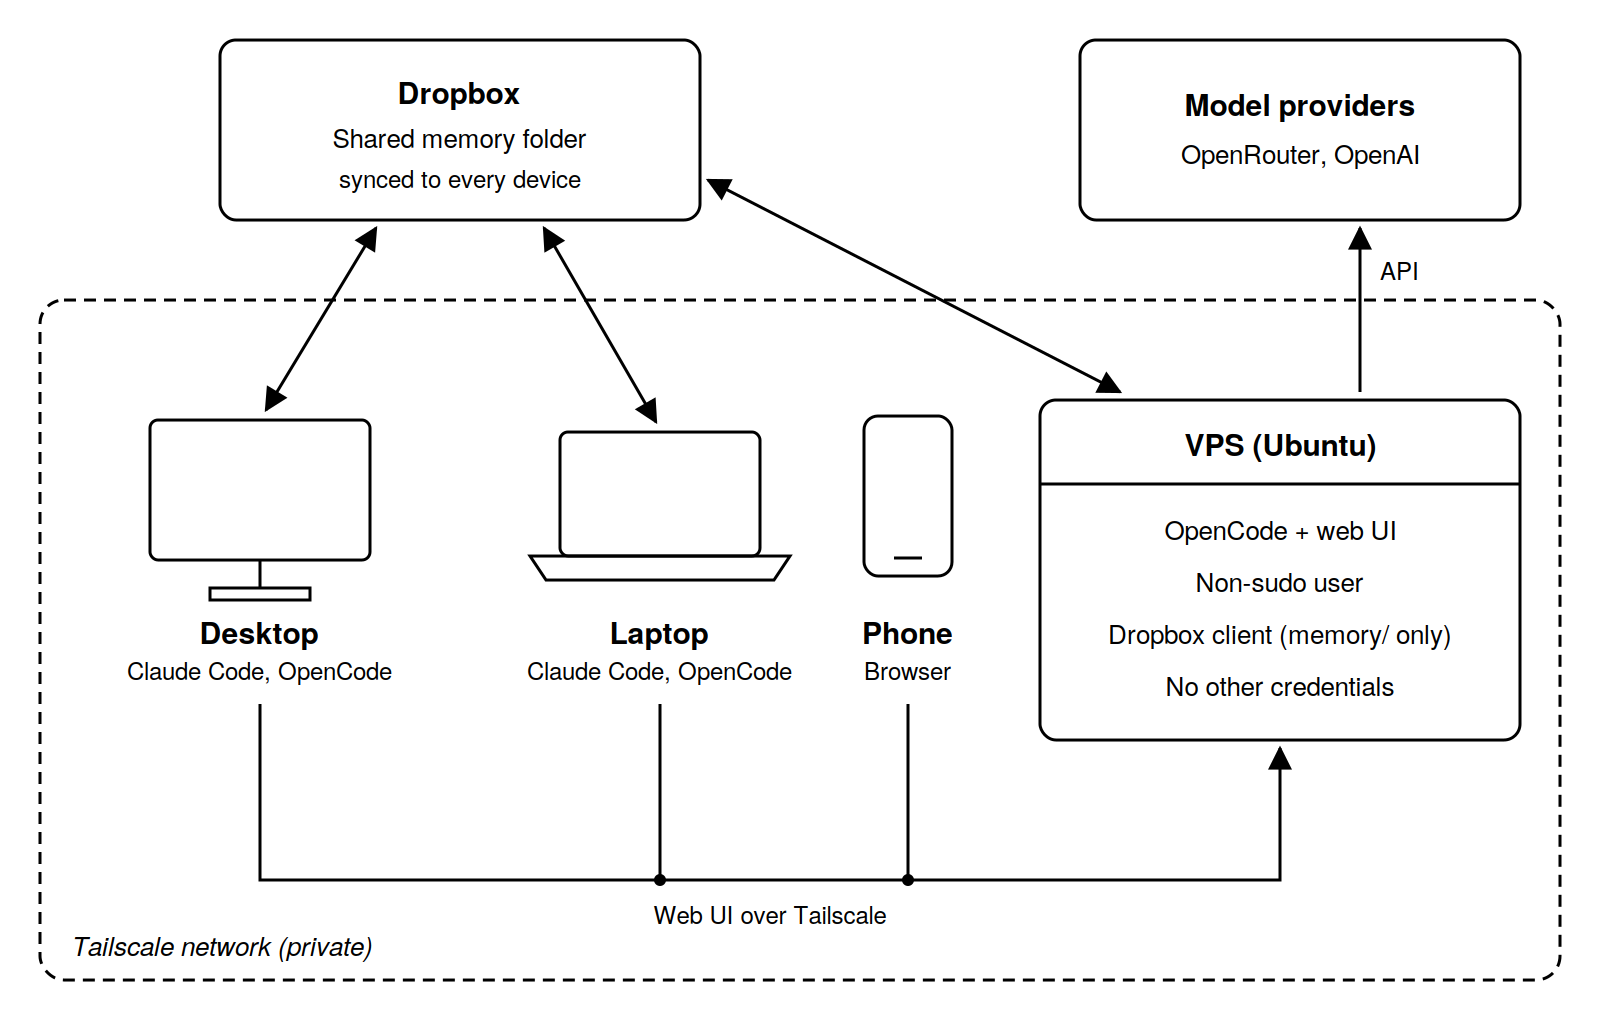
手機上的文章規劃,回家能換工具接續嗎?Victor 自報靠共享筆記完成;SvGrid 則以十次建置觀察,專案指示如何改變套件選擇。兩者值得學的是交接方式,不是「AI 已經什麼都記得」。
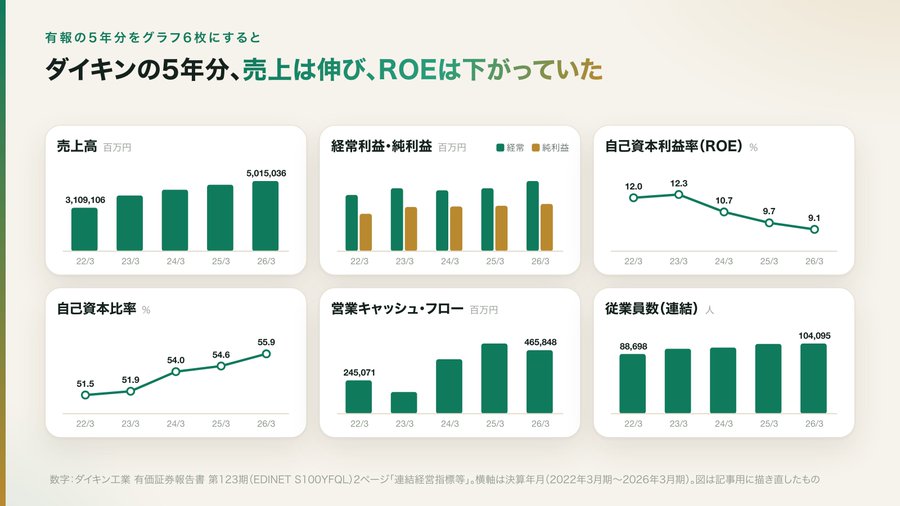
一位日文作者把大金年報整理成六張圖,但他明說用的是聊天 Artifacts,並非新推出的 Claude Dashboards。值得看的是先核對表格、再畫圖,以及合併報表、單位與括號人數的取值陷阱。
讀到完整研究,才看見76倍同時包含流程與模型改變。固定Sol與歷史預算,三次平均估算費用從US$1.97降到0.47,等待仍約四分鐘;總價答對了,要求的完整表格卻沒有交。這份32本書測試,能教你如何看代理成本與交付品質。
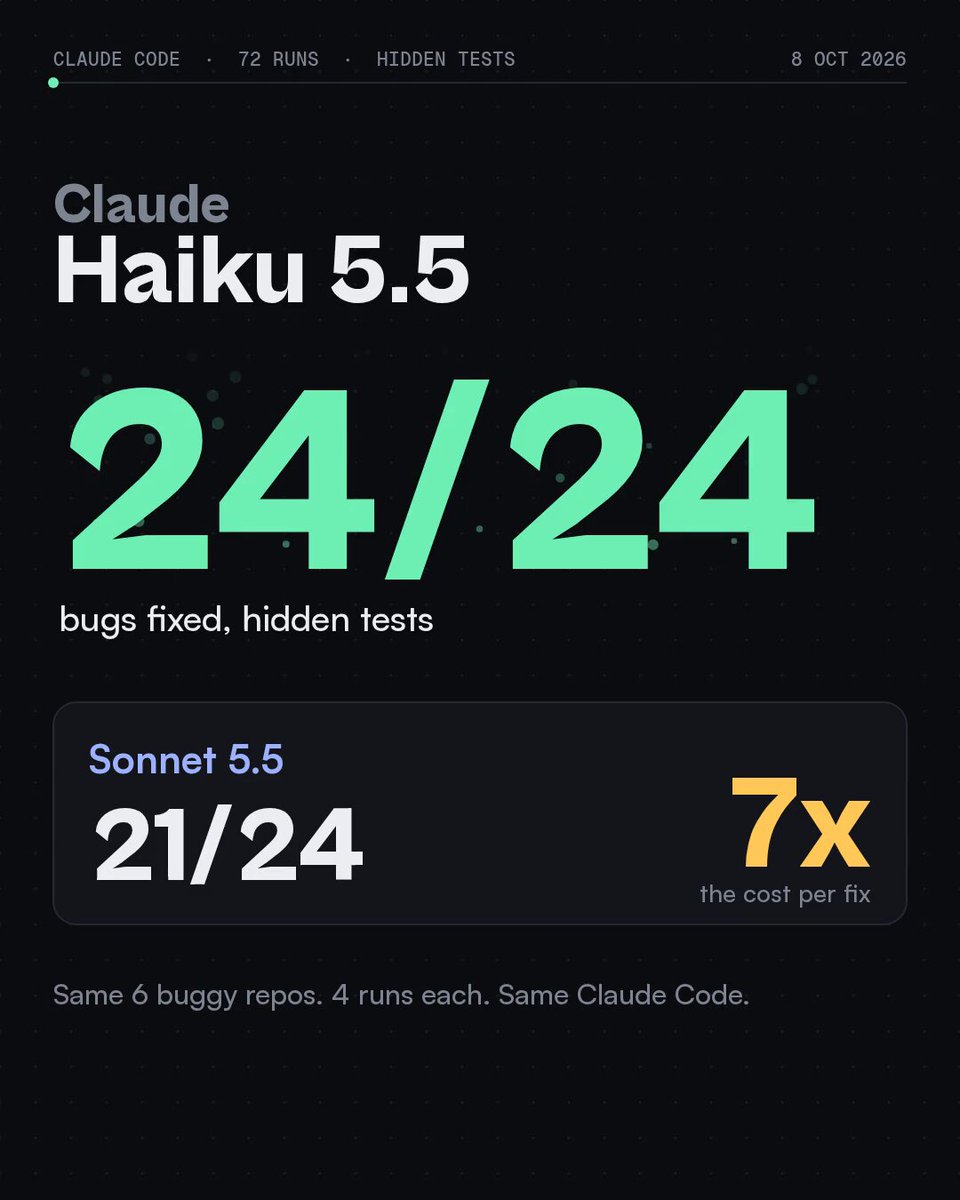
6 個小型 Python repo 各重跑 4 次,Haiku 全過,每次成功修復的牌價估算比 Sonnet 低,但完成時間中位數更長。換到兩個大型 repo 主動找漏,三次平均只修復 18.3/105。加上網站與 3D 展示,分清你買的是哪種成果。
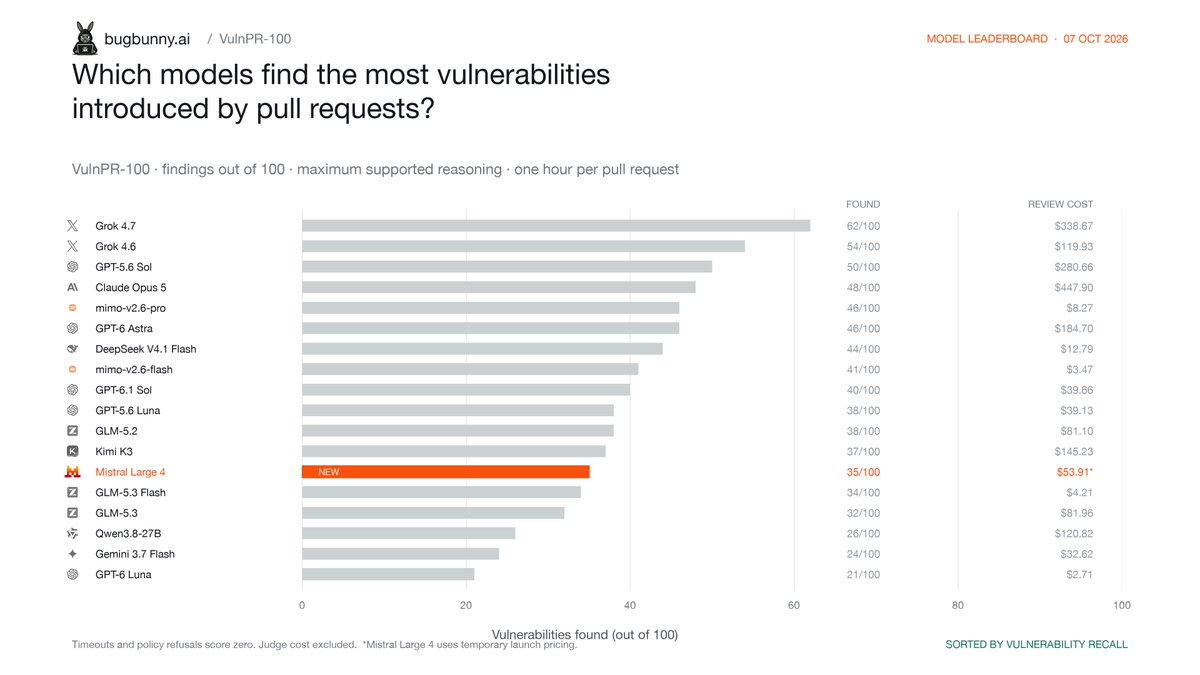
BugBunny 的原始測試給每個 PR 最多一小時:Large 4 找到 35/100,100 次審查費用 US$53.91,五次逾時。它比同表的 GLM-5.3 找到更多、費用更低,但 MiMo 與 DeepSeek 對照找到更多漏洞且費用更低;這份表仍沒有回答日常審查的誤報負擔。
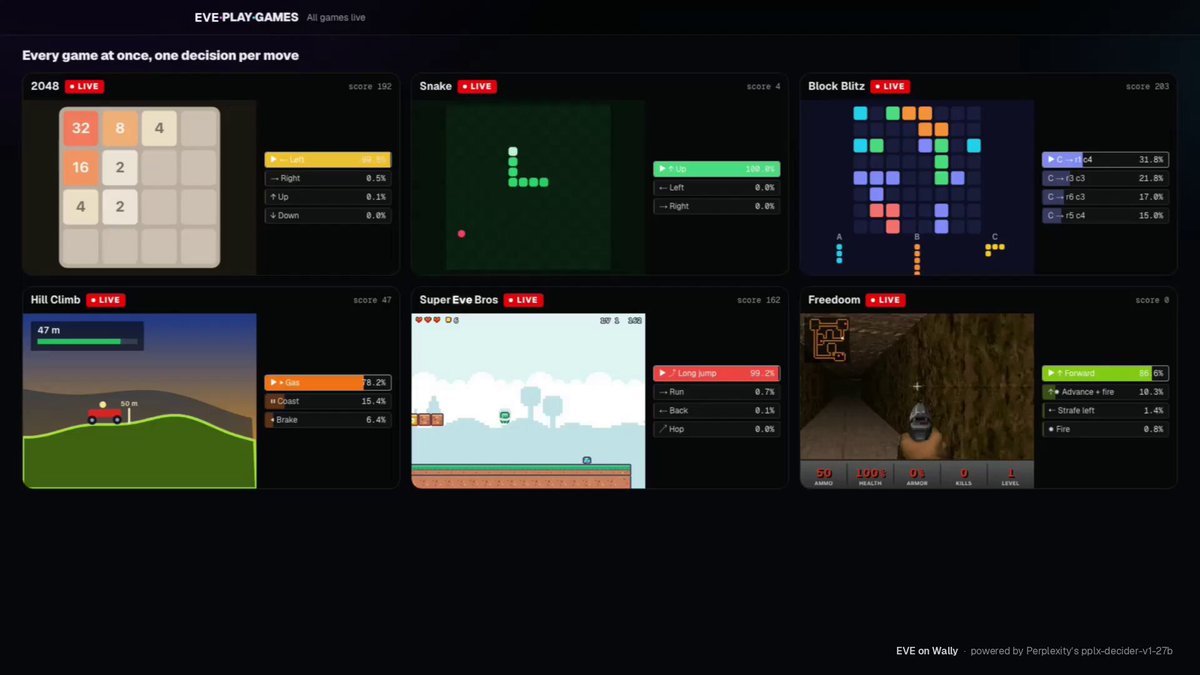
RunAnywhere 展示讀畫面、選動作並回傳機率的 EVE,底層是 Perplexity 的公開決策模型。可選託管或自架,但約 49 GiB 權重加工作記憶體不是一般筆電門檻;150 ms 與 Jev 的另一套測量也不能直接換算四倍速度。
Mods 已有用量面板與指令預覽範例;10/4 的 2.1.289 又修正受管理機器上,複合 shell 指令內層的 deny/ask 規則被 Mod 核准蓋過的問題。官方修復說明與第三方長期穩定性,要分開看。
從生成影片走向實體控制。官方展示取物與跨場景操作,網友追問握力如何判斷;網站的「open-weight」是未來發布承諾,目前僅合作夥伴測試。
Ai2 公開大型 MoE 訓練系統:47B 模型在八張 B300 的初步測試更快。兆級參數是系統容量測試,不能讀成已有兆級模型品質成績。
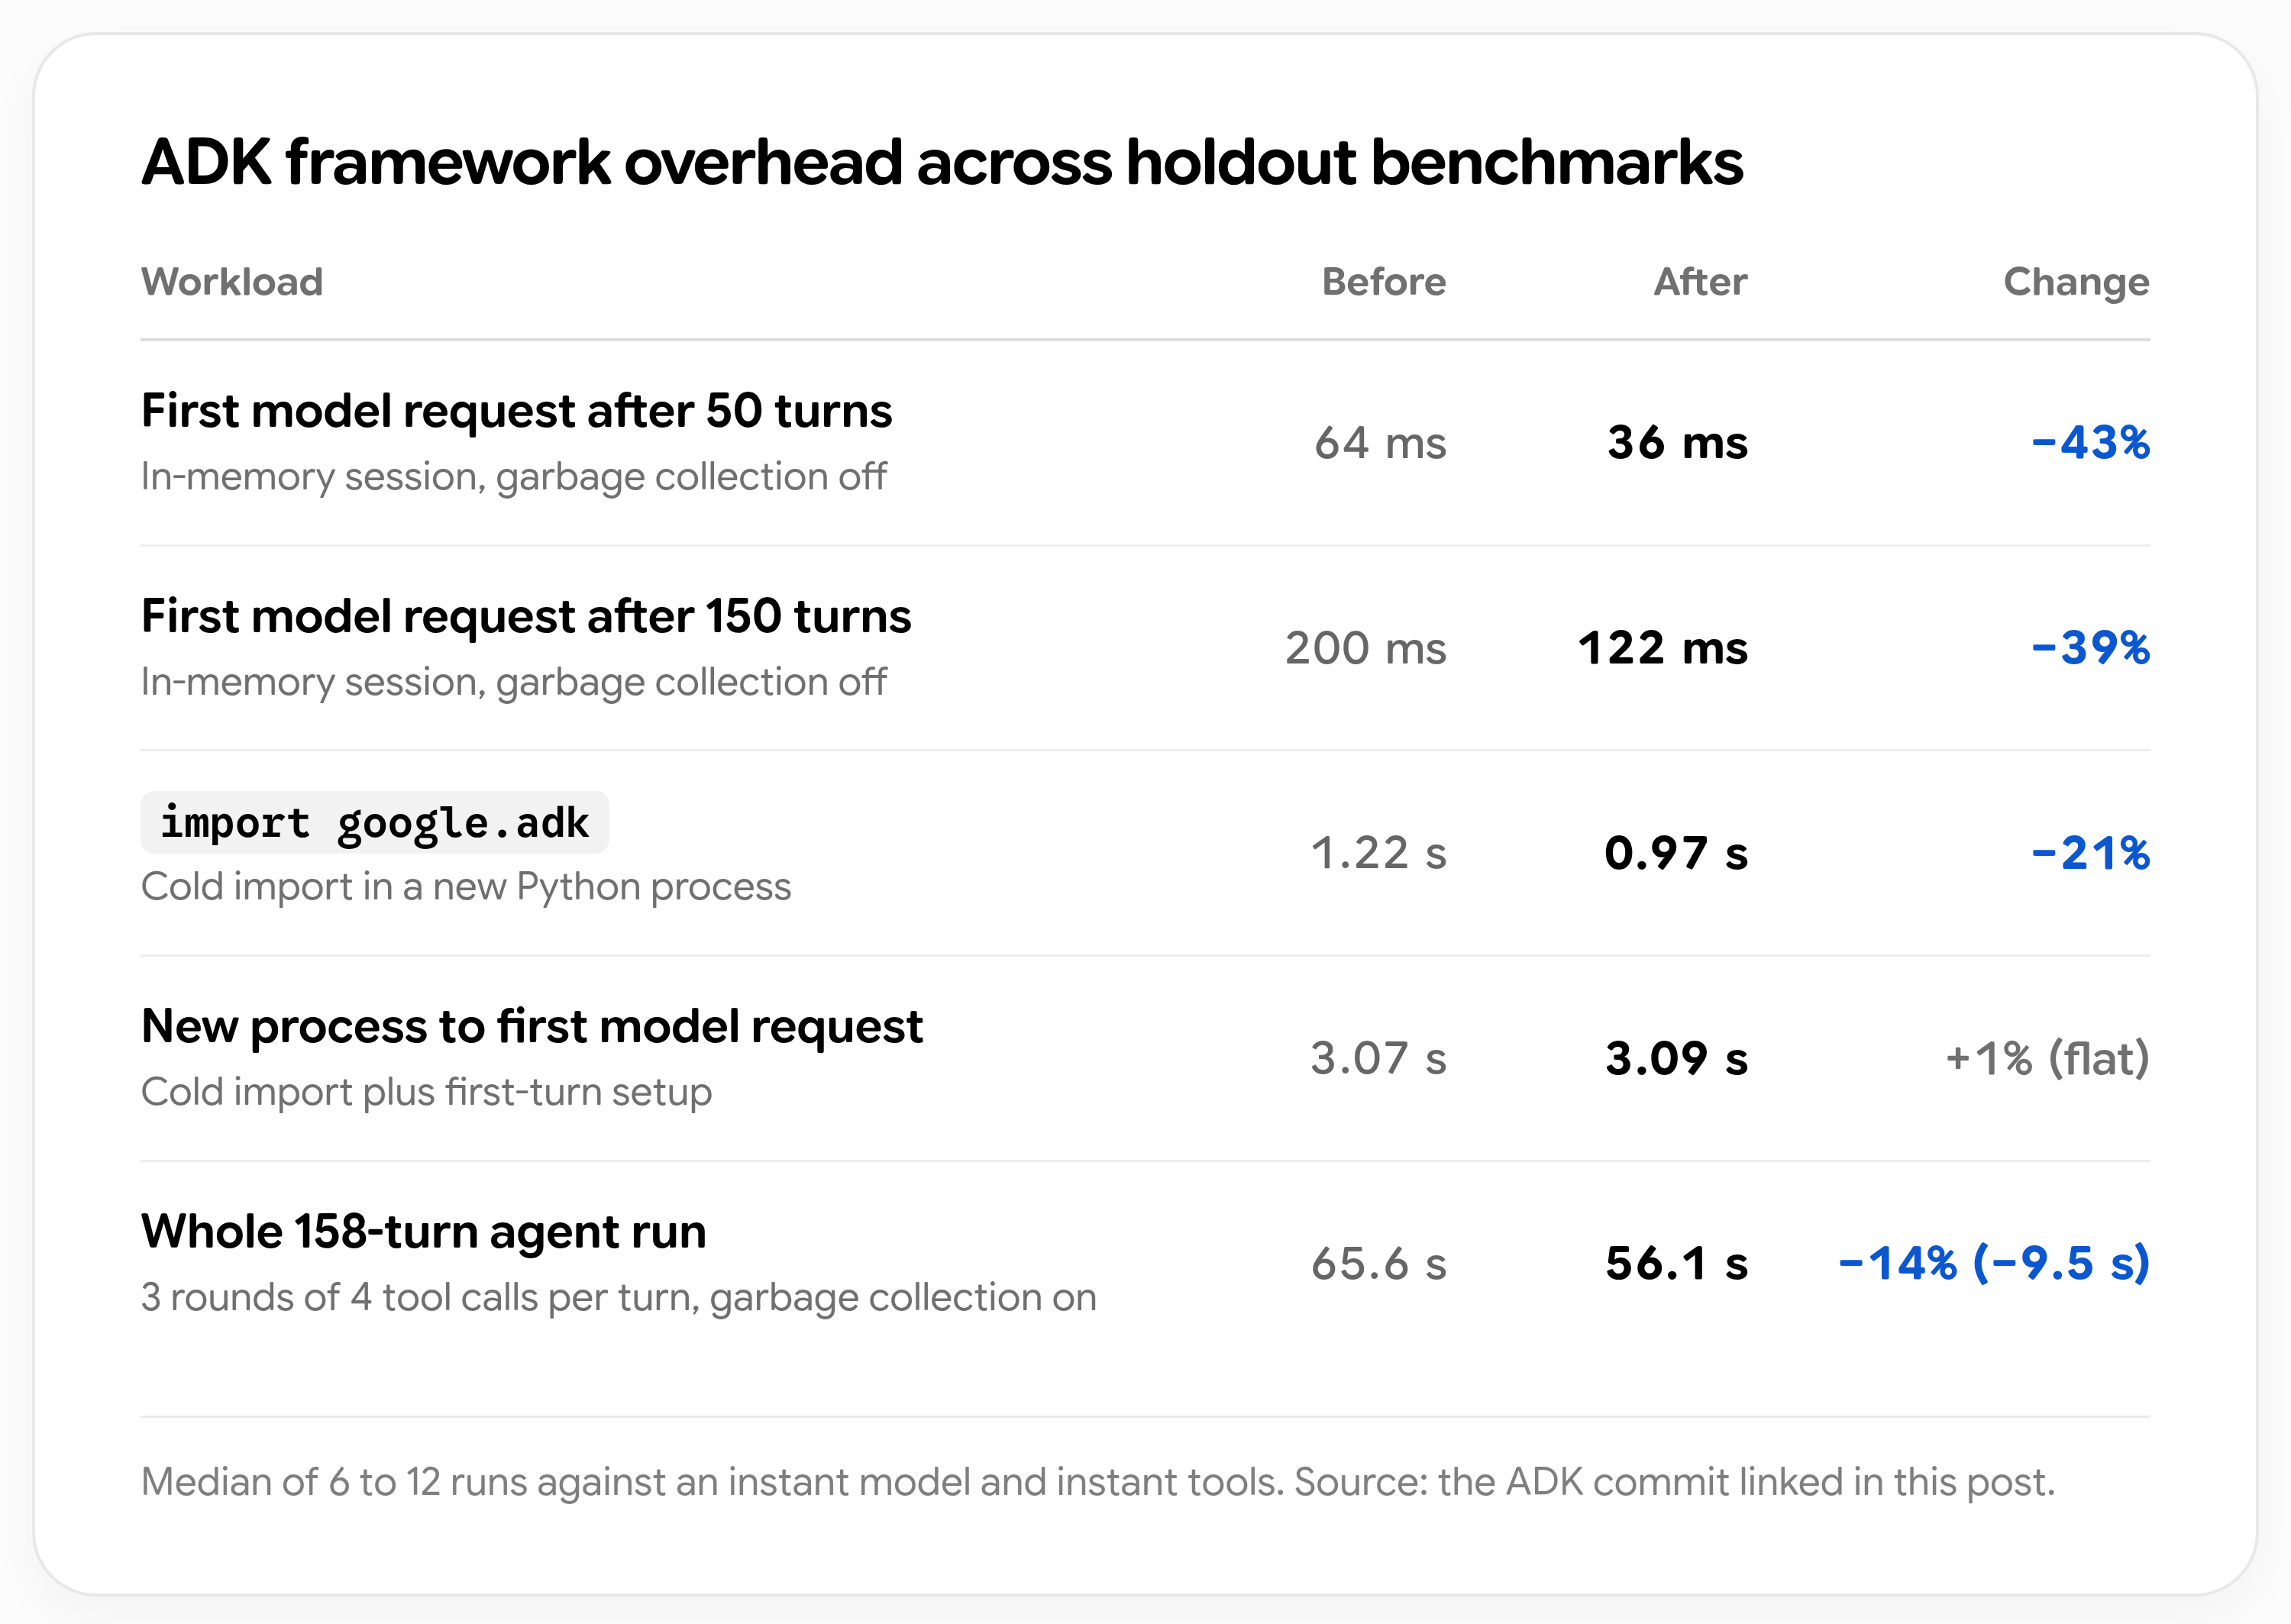
Google 已列出付費 API、Gemini Pro/Ultra 與 Antigravity 的不同入口。新增 ADK 工程案例:11 小時提出六項改動,人類 review 留下兩項;另有日文使用者比較相同知識與 Skill,偏好 Opus 的可讀性。把開放條件、工程耗時、日常閱讀分開看。
舊文的 Decision Index 比較來自 Liquid API 版 d1 與 Jev:廠商重測為 58.9 對 57.9,分項有輸有贏。現在 d1-3B 權重已公開,但模型卡另列的 48.57 是開放本機版用官方 scorer 自測、非排行榜提交;版本和測試條件不同,不能照搬舊分數。
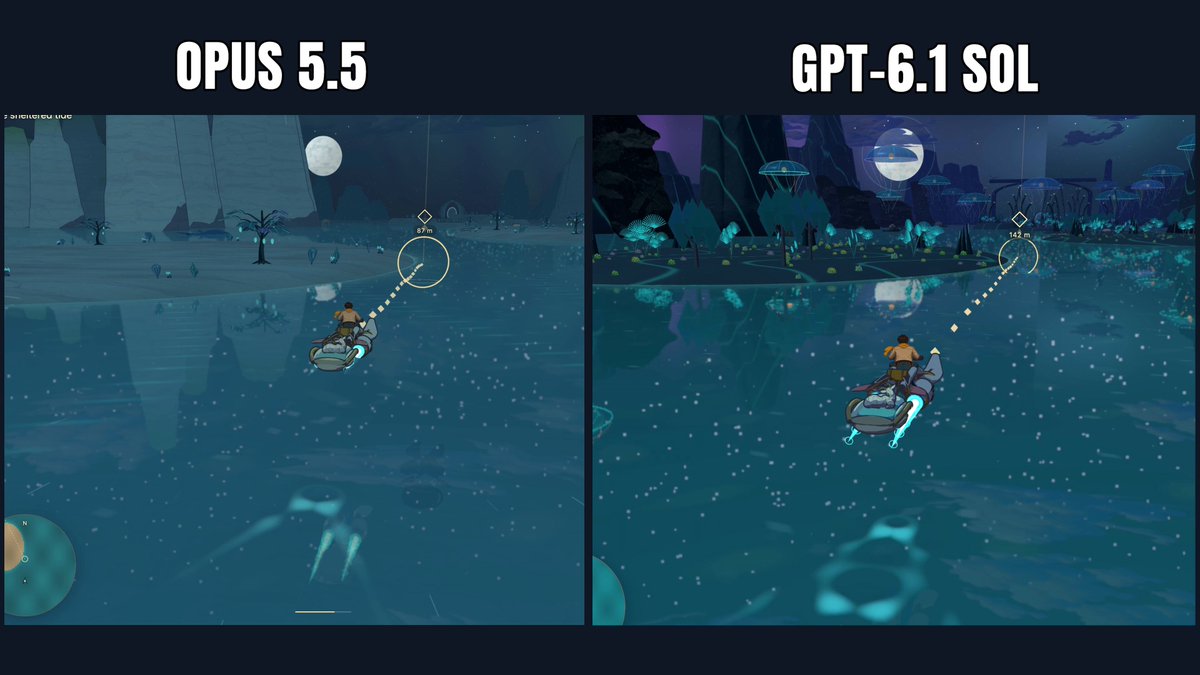
同組除錯,Sol/Astra 三次平均估算費用 $5.88/$33.03;另一組熔岩燈比較,6.1 Sol 卻比 6 Sol 久、標示費用也略高。串起具體成果、玩法缺陷和額度反例,分清比較對象與成本範圍。
分類只花 $0.08,完整流程其實還有 $3.99 的摘要費用。兩個創作者案例,看看快速決策模型放在工作流程的哪一段,以及還沒證明的部分。
先看完整版內測短片 SPARE,再對照創作者與觀眾的具體回應。完整版預告十月推出,現在開放的是 Ultra 年繳用戶的 Flash;原生 30 秒能力與已剪好的整部短片長度不能混為一談。
9 月 30 日發布的 DeepGEMM-Ascend,加上 DeepEP 與 TileLang 的昇騰支援,把計算、跨晶片通訊與寫算子的工具一起補上。亮眼數字屬特定測試;DeepEP 使用的 PoC 韌體配置尚未公開分發。
Hugging Face 9 月 30 日推出 Open TTS Leaderboard。我們切到中文與無聲音複製,看到 OmniVoice 與 AuK 的辨字錯誤率幾乎相同,離線速度卻有差距;榜單還能直接聽同一段文字的輸出。
從 Dots、Sol 到 Agents API,這次更新包含不同的推出階段。本文區分已開放、有限預覽與預告,並保留工程師對代理操作權限的原話提問。
Dots 具備雲端電腦,能維持工作脈絡。Every 的初期回報提到使用習慣正在形成,也遇到漏訊息與權限問題;日常可靠度值得持續觀察。
Anthropic 主打更快、每件任務更省。X 上有人稱讚單檔網頁成果,也有人在與 Opus 的比較中不滿品質;不同任務得到的評價差距很大。