Argon 調高 effort 值得嗎?三次找漏測試與對不上的費用
同一套105個錯誤,Antigravity 的 high 三次修復37–45個,medium 是33–46個;平均差距還不足以選出穩定贏家。Gemini CLI 單次牌價估算較高,但新版彙總與逐次紀錄對不上。讀原帖、公開紀錄與中斷條件,比看名次有用。
同一套105個錯誤,Antigravity 的 high 三次修復37–45個,medium 是33–46個;平均差距還不足以選出穩定贏家。Gemini CLI 單次牌價估算較高,但新版彙總與逐次紀錄對不上。讀原帖、公開紀錄與中斷條件,比看名次有用。
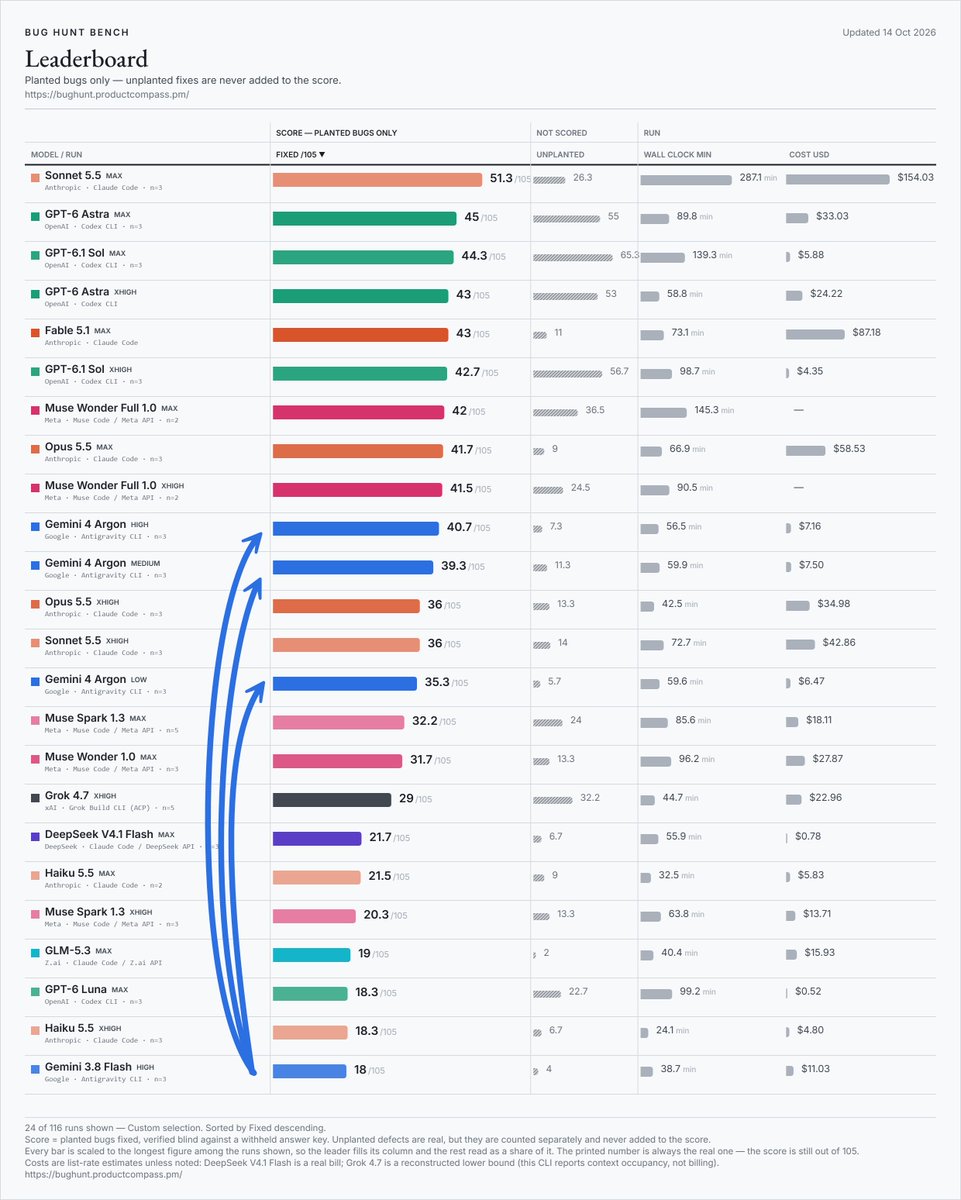
作者10/15原帖附圖(圖內更新日10/14)。high與medium各三次,圖上的平均無法顯示33–46等逐次波動。費用種類各異;Argon high 的US$7.16彙總尚無法與公開逐次紀錄對上,不能直接照圖推算省費倍率。
圖片:Paweł Huryn / Bug Hunt Bench · 原始展示 ↗
原帖有兩張模型輸出圖片,作者觀察到 Eureka 與自我批判的風格。這是 FrontierSWE 測試者自報,並非本站操作截圖或人人可用的產品入口。
來源:wh / @nrehiew_ · 開啟原貼文/影片 ↗作者自報完成時間與品質取捨;原影片不等於本站操作驗收。
來源:m0h · 開啟原貼文/影片 ↗服務方自家展示,沒有公開完整提示、場次或勝率。點擊載入原始影片,亦可開原文回查。
來源:RunAnywhere · 開啟原貼文/影片 ↗8 則資訊
同一套105個錯誤,Antigravity 的 high 三次修復37–45個,medium 是33–46個;平均差距還不足以選出穩定贏家。Gemini CLI 單次牌價估算較高,但新版彙總與逐次紀錄對不上。讀原帖、公開紀錄與中斷條件,比看名次有用。
Google 已列出付費 API、Gemini Pro/Ultra 與 Antigravity 的不同入口。新增 ADK 工程案例:11 小時提出六項改動,人類 review 留下兩項;另有日文使用者比較相同知識與 Skill,偏好 Opus 的可讀性。把開放條件、工程耗時、日常閱讀分開看。
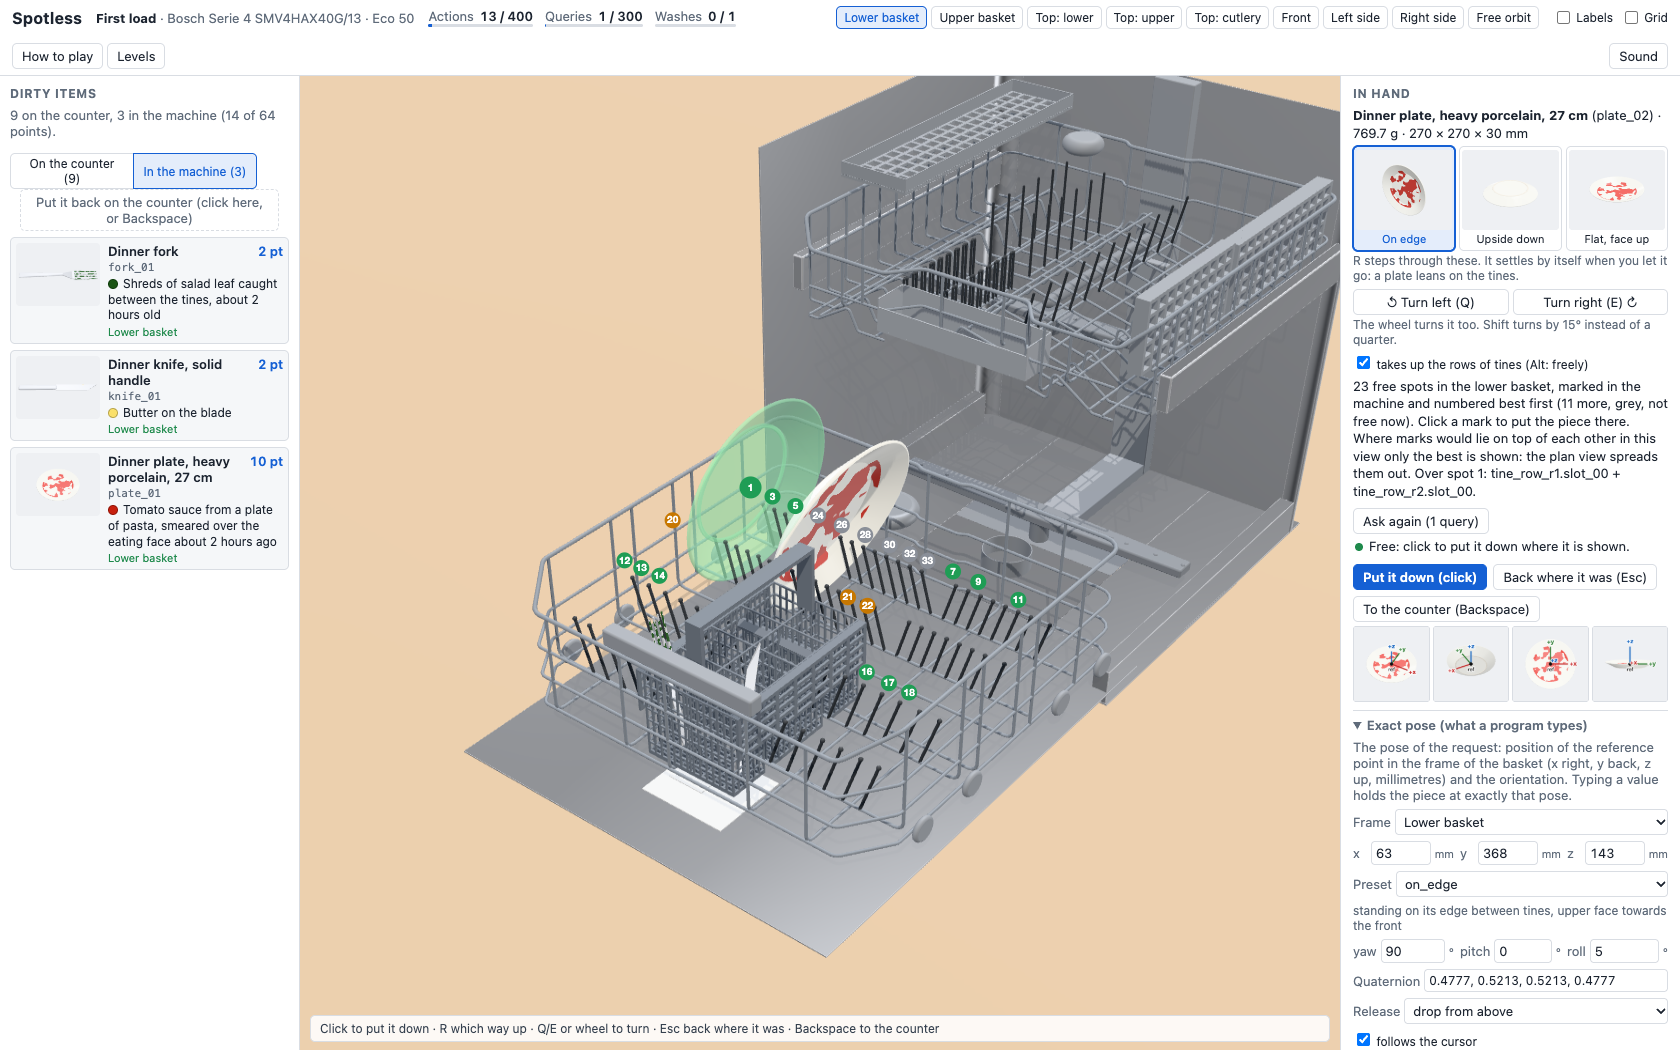
DishwasherBench 公開六次模型遊玩與逐步紀錄:Sol 會把擋住餐具籃的鍋子拿掉,Astra 會找空間多放大件餐具。但早期模擬器對倒下的盤子、擁擠餐具有盲點;這場遊戲目前更像裝載測試,不能直接當成洗碗能力排名。
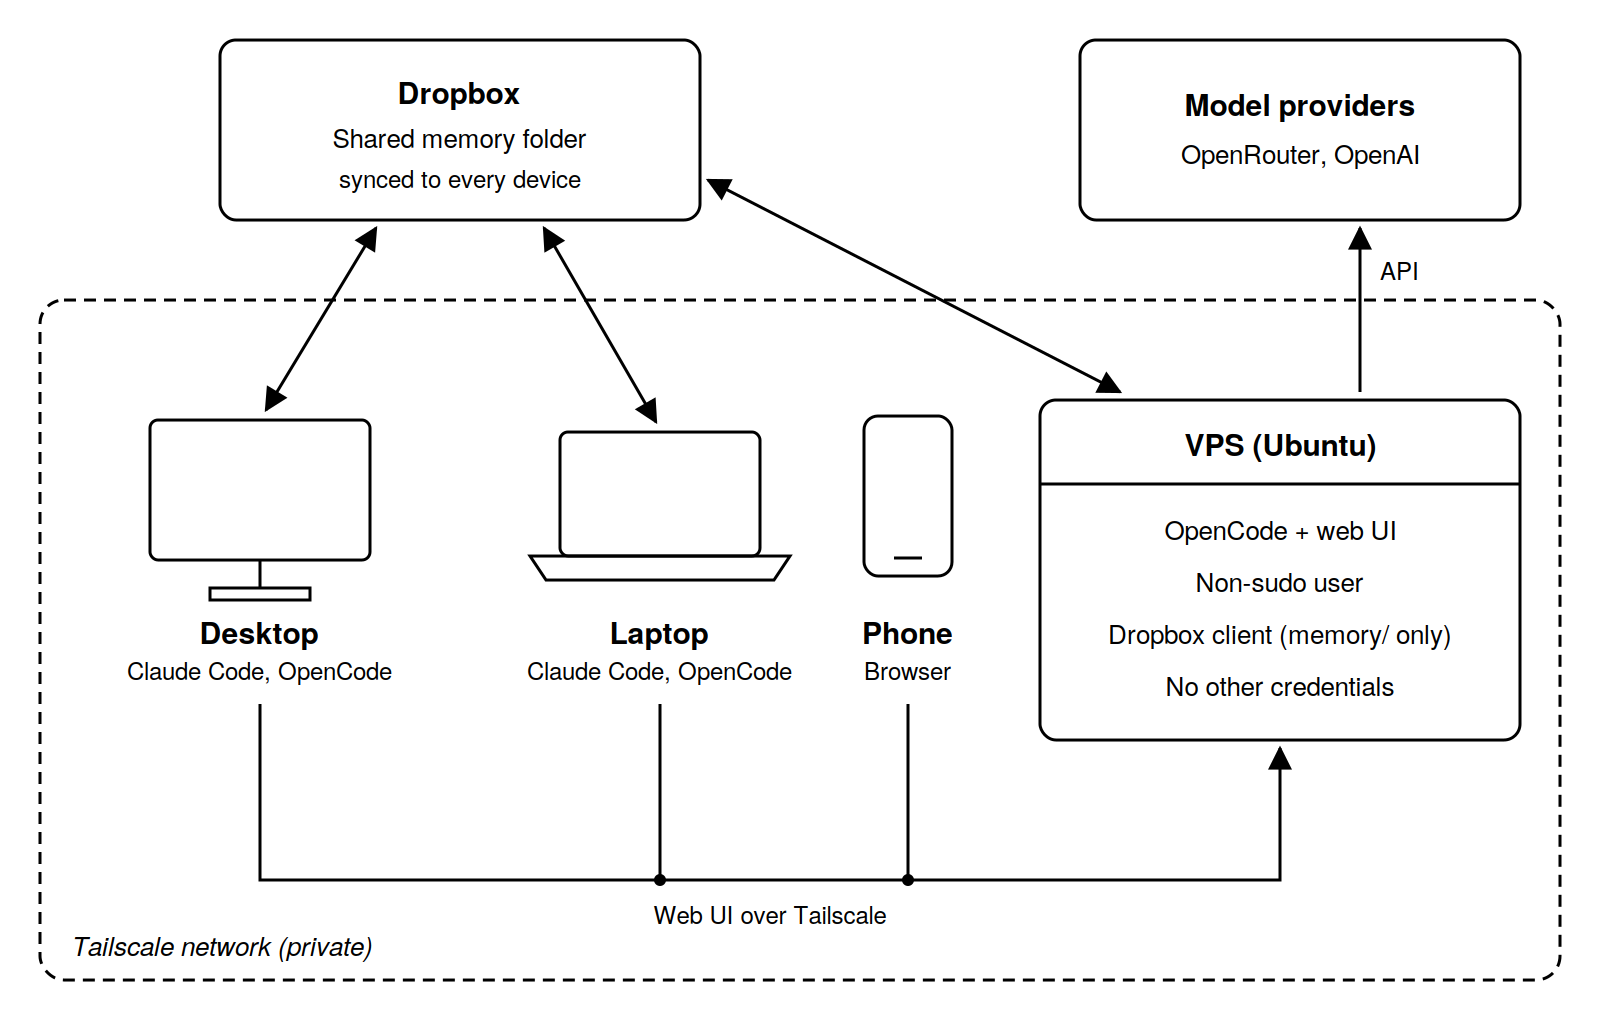
手機上的文章規劃,回家能換工具接續嗎?Victor 自報靠共享筆記完成;SvGrid 則以十次建置觀察,專案指示如何改變套件選擇。兩者值得學的是交接方式,不是「AI 已經什麼都記得」。
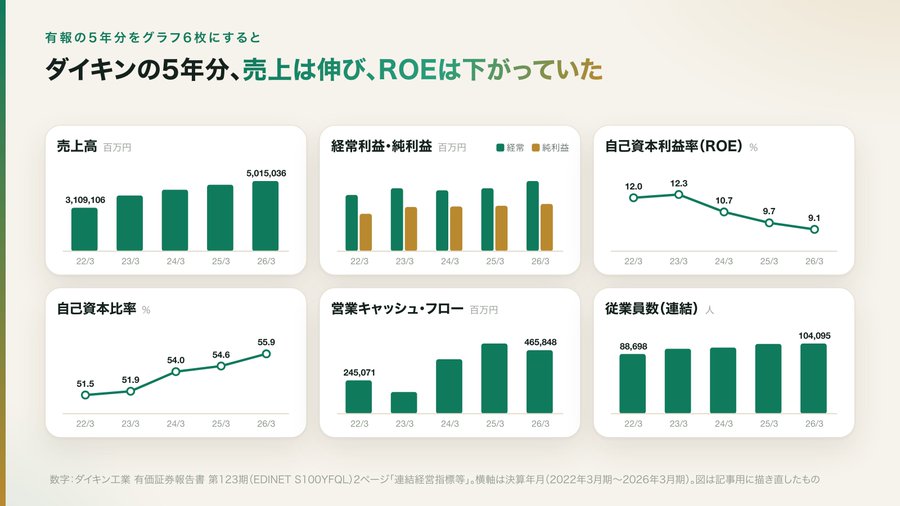
一位日文作者把大金年報整理成六張圖,但他明說用的是聊天 Artifacts,並非新推出的 Claude Dashboards。值得看的是先核對表格、再畫圖,以及合併報表、單位與括號人數的取值陷阱。
讀到完整研究,才看見76倍同時包含流程與模型改變。固定Sol與歷史預算,三次平均估算費用從US$1.97降到0.47,等待仍約四分鐘;總價答對了,要求的完整表格卻沒有交。這份32本書測試,能教你如何看代理成本與交付品質。
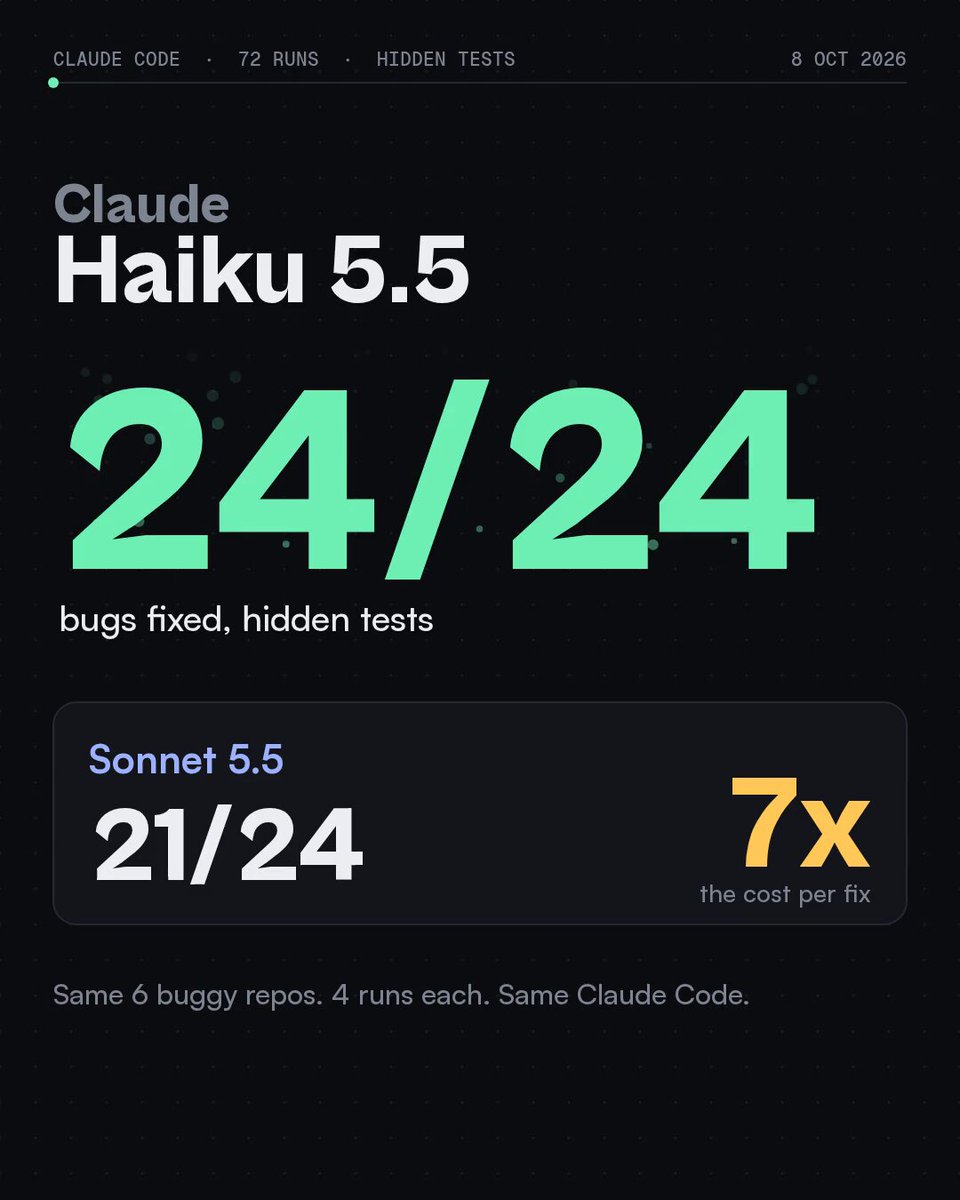
6 個小型 Python repo 各重跑 4 次,Haiku 全過,每次成功修復的牌價估算比 Sonnet 低,但完成時間中位數更長。換到兩個大型 repo 主動找漏,三次平均只修復 18.3/105。加上網站與 3D 展示,分清你買的是哪種成果。
舊文的 Decision Index 比較來自 Liquid API 版 d1 與 Jev:廠商重測為 58.9 對 57.9,分項有輸有贏。現在 d1-3B 權重已公開,但模型卡另列的 48.57 是開放本機版用官方 scorer 自測、非排行榜提交;版本和測試條件不同,不能照搬舊分數。